AWS Glue
El servicio de AWS para encontrar, describir y limpiar datos, sin servidores que correr.
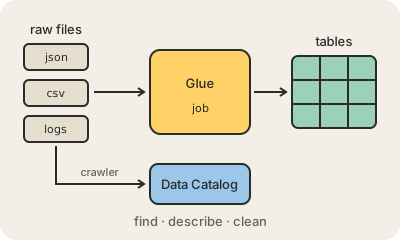
AWS Glue es el servicio de AWS para hacer ETL: tomar los datos de donde caen, limpiarlos y darles forma, y dejarlos donde la gente los pueda analizar. Un caso típico: todas las noches una app tira miles de archivos JSON en Amazon S3, y un job de Glue los lee, saca duplicados, corrige fechas, los cruza con una tabla de clientes y escribe el resultado como archivos Parquet listos para consultar.
Su otra mitad es el Glue Data Catalog, un registro de cada conjunto de datos: dónde están los archivos, qué columnas tienen y de qué tipo. Un crawler lo puede llenar por vos: abre los archivos y deduce su estructura. El catálogo es lo que permite que Amazon Athena o Amazon Redshift consulten una carpeta de archivos en S3 como si fuera una tabla.
Glue es serverless: escribís la transformación (en Python o SQL sobre Apache Spark, o arrastrando cajas en un editor visual), decís cuándo tiene que correr, y AWS levanta las máquinas mientras dura el job. Pagás por el tiempo de procesamiento usado, no por clusters ociosos. Por eso es el pegamento, como dice su nombre (glue), de muchos data lakes armados en AWS.
Para quedarse
- Corre jobs de ETL sobre Apache Spark sin que administres un cluster.
- El Data Catalog describe los datos para que Athena y Redshift los consulten como tablas.
- Los crawlers revisan archivos y deducen solos sus columnas y tipos.
- Se cobra por tiempo de procesamiento mientras corren los jobs; entre jobs no corre nada.