Data lake
Almacenamiento barato donde todos los datos se guardan como archivos crudos.
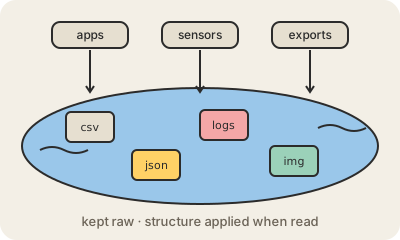
Un data lake (lago de datos) es un depósito grande y barato donde una organización guarda todos sus datos como archivos, con la forma que tengan al llegar: logs de las apps, exportaciones CSV, eventos en JSON, imágenes, lecturas de sensores. No hace falta modelar nada antes de que entre. En AWS suele ser Amazon S3 con una organización de carpetas y algunas reglas; la estructura se aplica después, cuando alguien lee los datos.
Esa es la diferencia clave con un data warehouse. Un warehouse te pide limpiar y modelar los datos antes de cargarlos (schema on write); un lake acepta todo y deja que cada lector decida cómo interpretarlo (schema on read). Motores de consulta como Amazon Athena o Spark leen los archivos donde están, y un catálogo registra qué hay en cada carpeta para que la gente lo encuentre.
Los lakes son populares porque guardar es barato y no se tira nada: la pregunta de mañana, o el modelo de machine learning de mañana, puede necesitar datos que hoy nadie creía útiles. El riesgo es el data swamp (el pantano): años de archivos sin documentar, duplicados o medio rotos, en los que nadie confía. Muchos equipos hoy combinan las dos ideas en un lakehouse: archivos en el lake, guardados en formatos como Parquet, con una capa de tablas encima que suma las garantías de un warehouse.
Para quedarse
- Guarda archivos crudos de cualquier tipo; la estructura se aplica al leer.
- Suele armarse sobre almacenamiento de objetos como Amazon S3, barato y prácticamente ilimitado.
- Sin un catálogo y algo de disciplina, se convierte en un data swamp.
- Lakes y warehouses se complementan; un lakehouse mezcla los dos.