Apache Spark
Un motor open source que reparte el trabajo con datos enormes entre muchas máquinas.
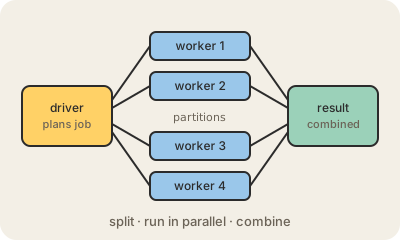
Apache Spark es un motor open source para procesar datos que son demasiado grandes, o demasiado lentos, para una sola computadora. Vos describís lo que querés (leé estos archivos, filtrá, juntá, agrupá, escribí el resultado) y Spark divide los datos en particiones, las manda a muchas máquinas de un cluster, corre los pasos en paralelo y junta la respuesta. Se puede escribir en SQL (Spark SQL), Python (PySpark), Scala, Java o R.
Nació en la Universidad de Berkeley alrededor de 2009 y se convirtió en un proyecto de Apache, pensado para mejorar a Hadoop MapReduce, que escribía los resultados intermedios en disco entre cada paso. Spark guarda todo lo que puede en memoria y planifica el trabajo completo antes de correrlo, y eso hace mucho más rápidas las tareas de varios pasos. Un driver central arma ese plan; los executors en las máquinas worker hacen el trabajo, y si uno falla, Spark recalcula solo las partes perdidas.
Hoy Spark es un caballo de batalla de la ingeniería de datos: procesos de ETL nocturnos sobre un data lake, limpieza de miles de millones de eventos, preparación de datos para entrenar modelos de machine learning y procesamiento de streams en tandas chicas. Casi nunca se instala a mano; corre como servicio administrado en Databricks, Amazon EMR, AWS Glue o Google Cloud Dataproc. Para datos que entran en una sola máquina, muchas veces hay herramientas más simples, más rápidas y más baratas.
Para quedarse
- Divide los datos en particiones y las procesa en paralelo en un cluster.
- Guarda los datos intermedios en memoria, y por eso fue mucho más rápido que MapReduce.
- Se usa desde SQL, Python (PySpark), Scala, Java o R.
- Suele correr como servicio administrado, como Databricks, EMR o Glue.