ETL
Sacar datos de sus fuentes, limpiarlos y cargarlos donde se puedan analizar.
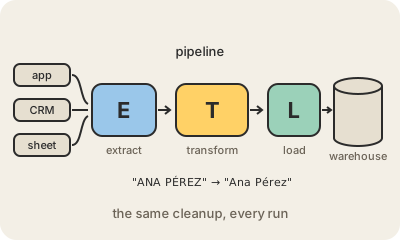
ETL viene de extract, transform, load (extraer, transformar y cargar): los tres pasos para llevar datos desde los sistemas donde nacen hasta el lugar donde se analizan. Extraer es leerlos de las fuentes: la base de la app, un CRM, la API del proveedor de pagos, planillas. Transformar es limpiarlos y darles forma. Cargar es escribir el resultado en un data warehouse o un data lake.
En la transformación se esconde la mayor parte del trabajo. Las fechas vienen en tres formatos, el mismo cliente aparece como 'ANA PÉREZ' en un sistema y 'Ana Perez' en otro, los precios están en distintas monedas, algunas filas están duplicadas y a otras les falta un campo. El pipeline arregla todo eso de la misma forma cada vez, para que los números del tablero sean confiables y se puedan comparar mes a mes.
Los pipelines corren con un horario (todas las noches, cada hora) o de forma continua, y cuando uno se rompe se nota en un tablero que deja de actualizarse sin avisar. Muchos equipos hoy invierten el orden y hacen ELT: primero cargan los datos crudos y después los transforman adentro del warehouse con SQL, algo que tiene sentido ahora que los warehouses son potentes y guardar es barato. Herramientas como AWS Glue, Apache Airflow, dbt y Fivetran existen para armar, programar y monitorear estos pipelines.
Para quedarse
- Extraer de las fuentes, transformar (limpiar, unir, estandarizar) y cargar en el destino.
- La mayor parte del esfuerzo, y de los errores, está en la transformación.
- ELT carga primero los datos crudos y los transforma adentro del warehouse.
- Los pipelines corren con horario o de forma continua, y hay que monitorearlos para saber cuándo se rompen.