Evals de IA
Pruebas propias para tu app de IA, que revisan si cumple antes y después de cada cambio.
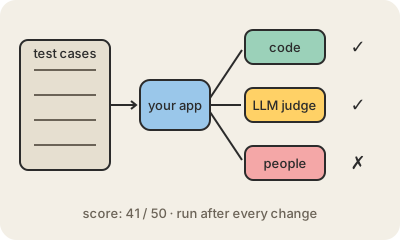
Las evals (por evaluaciones) son los tests de un producto de IA. Juntás un conjunto de entradas realistas, corrés tu sistema con ellas y calificás las salidas de forma automática. A diferencia de un benchmark de IA público, que compara modelos en habilidades generales, tus evals miden lo que a vos te importa: si el bot de soporte contesta bien las preguntas sobre reembolsos, si el resumidor conserva la cláusula que importa.
Hay tres maneras de calificar. Algunos controles son código común: si la salida es JSON válido, si menciona el número de pedido correcto, si el código generado pasa sus tests. Otros usan un segundo modelo como corrector, lo que se conoce como LLM-as-a-judge (un LLM como juez), con una rúbrica clara del estilo "¿la respuesta cita la política y mantiene un tono amable?". Y otros necesitan personas, que además verifican que los correctores automáticos coincidan con el criterio humano.
Las evals importan porque el comportamiento de un LLM es difícil de prever, y un cambio chico puede romper algo lejos. Un prompt nuevo que arregla un caso puede arruinar otros diez sin que nadie se dé cuenta; una versión nueva del modelo puede ser más inteligente en general pero peor con tu formato. Con un buen set de evals podés cambiar el prompt, el modelo o la búsqueda de documentos y saber en minutos si mejoró o empeoró, en vez de enterarte por los usuarios. Un set útil puede arrancar chico, con unas decenas de ejemplos reales, y crecer cada vez que algo falla en producción.
Para quedarse
- Una eval es un conjunto de casos de prueba más una forma de calificarlos, hecha para tu tarea.
- Pueden calificar el código, otro LLM (LLM-as-a-judge) o personas.
- Se corren después de cada cambio de prompt, modelo o datos, para detectar retrocesos.
- Los benchmarks comparan modelos; las evals revisan tu producto.
Para seguir leyendo
- Demystifying evals for AI agents (Anthropic, en inglés)
- Define success criteria and build evaluations (documentación de Claude, en inglés)
- Your AI product needs evals (Hamel Husain, en inglés)