Benchmark de IA
Una prueba estándar que rinden los modelos de IA para comparar lo que saben hacer.
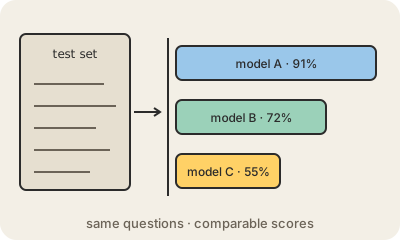
Un benchmark de IA es un conjunto fijo de tareas con respuestas correctas conocidas que se le toma a un modelo para medir qué tan bien le va. Todos los modelos rinden la misma prueba con las mismas reglas, así los puntajes se pueden comparar. Cuando una empresa lanza un modelo, el anuncio casi siempre trae una tabla con resultados de benchmarks.
Cada benchmark apunta a una habilidad. MMLU hace preguntas de opción múltiple de decenas de materias de secundaria y universidad. GPQA tiene preguntas de ciencia de nivel de posgrado, pensadas para que no se puedan googlear. SWE-bench le da al modelo bugs reales de proyectos open source y revisa si su arreglo pasa los tests. Otros miden matemática, lectura de documentos largos o uso de una computadora. Un estilo distinto, como LMArena, no usa respuestas correctas: la gente compara dos respuestas anónimas y vota la mejor.
Hay que leer los números con cuidado. Los benchmarks se saturan: cuando los mejores modelos sacan cerca del 100%, la prueba ya no los distingue y hay que inventar otras más difíciles. Las preguntas se pueden filtrar en los datos de entrenamiento, así que un modelo puede haber visto las respuestas. Y las empresas tienden a mostrar las pruebas donde quedan bien. Un puntaje es una señal útil, pero el mejor control sigue siendo probar el modelo con tus propias tareas.
Para quedarse
- Mismas preguntas, mismas reglas, puntajes comparables entre modelos.
- Cada benchmark mide una habilidad: conocimiento, matemática, código, uso de herramientas.
- Las pruebas se saturan y se filtran al entrenamiento, por eso aparecen nuevas todo el tiempo.
- El benchmark que más te importa son tus propias tareas.
Para seguir leyendo
- Language model benchmark en Wikipedia (en inglés)
- SWE-bench (en inglés)
- HELM: Holistic Evaluation of Language Models (Stanford, en inglés)