Aprendizaje por refuerzo
Aprender por prueba y error, guiado por recompensas cuando algo sale bien.
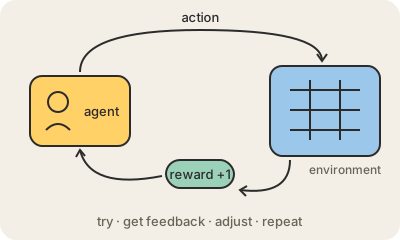
El aprendizaje por refuerzo (reinforcement learning, RL) es una forma de entrenar IA en la que nadie le muestra al sistema las respuestas correctas. En cambio, un agente actúa en algún entorno (un juego, una simulación, una conversación), recibe una recompensa cuando las cosas salen bien y una penalización cuando salen mal, y de a poco aprende qué acciones le dan más recompensa. Es prueba y error, repetido millones de veces.
Su éxito más famoso llegó en 2016, cuando AlphaGo, de DeepMind, le ganó a Lee Sedol, uno de los mejores jugadores del mundo de Go, un juego de mesa que durante mucho tiempo se creyó demasiado sutil para una computadora. AlphaGo mejoró en parte jugando contra sí mismo una y otra vez. El RL también se usa para enseñarles a robots a caminar o agarrar cosas, para controlar la refrigeración de centros de datos y en muchos sistemas que juegan.
Para los chatbots de hoy, el RL importa de dos maneras. El RLHF (aprendizaje por refuerzo con retroalimentación humana) es una etapa en la que personas comparan pares de respuestas, un modelo aparte aprende sus preferencias y después se entrena al chatbot para que dé respuestas que ese modelo de preferencias puntúe bien. Es buena parte de por qué los asistentes suenan útiles y amables. Más recientemente, el RL sobre problemas con respuestas verificables, como matemática y código, se usó para entrenar modelos que razonan paso a paso. El riesgo clásico es el reward hacking: el agente encuentra un atajo que suma puntos sin hacer lo que de verdad querías, así que la recompensa hay que diseñarla con cuidado.
Para quedarse
- Aprende de recompensas y penalizaciones, no de respuestas etiquetadas.
- La victoria de AlphaGo en Go en 2016 es el ejemplo emblemático.
- El RLHF usa preferencias humanas para moldear cómo responden los chatbots.
- Una recompensa mal diseñada se aprovecha: reward hacking.
Para seguir leyendo
- Aprendizaje por refuerzo en Wikipedia
- ¿Qué es el aprendizaje por refuerzo? (IBM)
- RLHF explicado, Hugging Face (en inglés)