Aprendizaje supervisado y no supervisado
Dos formas de aprender de una máquina: con ejemplos resueltos o buscando patrones sola.
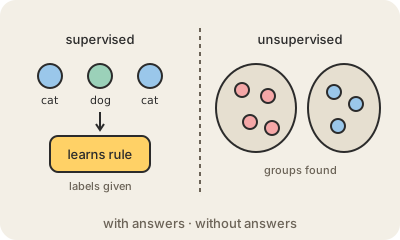
En el aprendizaje supervisado, cada ejemplo de entrenamiento viene con la respuesta correcta pegada, que se llama etiqueta. Miles de mails marcados como "spam" o "no spam", fotos de lunares marcadas como "benigno" o "maligno", departamentos vendidos con su precio. El modelo estudia los pares y aprende una regla que va de la entrada a la respuesta, así puede predecir la etiqueta de algo nuevo. Ordenar en categorías se llama clasificación; predecir un número, como un precio, se llama regresión.
En el aprendizaje no supervisado no hay respuestas. El modelo recibe los datos en crudo y busca estructura: clientes que se comportan parecido (clustering), operaciones que no se parecen a ninguna otra (detección de anomalías, útil contra el fraude), o una forma más simple de describir los datos. Nadie le dice qué significan los grupos; una persona tiene que mirarlos y decidir si sirven.
La diferencia importa porque las etiquetas son caras: alguien las tiene que escribir, muchas veces a mano. Por eso se volvió central un tercer enfoque, el aprendizaje autosupervisado, donde los datos se etiquetan solos. Los modelos de lenguaje grandes aprenden así: tapan la palabra siguiente de un texto real y tratan de adivinarla, lo que convierte a internet entera en material de práctica sin que nadie etiquete nada.
Para quedarse
- Supervisado: los ejemplos traen etiqueta y el modelo aprende a predecirla.
- No supervisado: sin etiquetas; el modelo encuentra grupos y casos raros.
- Etiquetar datos es lento y caro, y muchas veces eso decide qué enfoque se usa.
- Los LLMs se entrenan sobre todo con aprendizaje autosupervisado sobre texto común.
Para seguir leyendo
- Aprendizaje supervisado vs. no supervisado (IBM)
- Aprendizaje supervisado en Wikipedia
- Aprendizaje no supervisado en Wikipedia