Entrenamiento e inferencia
Entrenar construye el modelo una vez; inferir es usarlo, millones de veces por día.
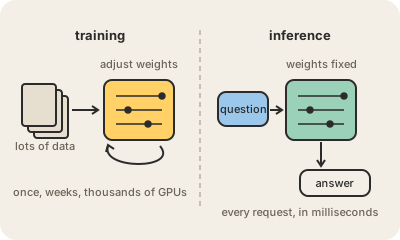
Un modelo de IA tiene dos vidas muy distintas. El entrenamiento es cuando aprende: la red neuronal ve cantidades enormes de datos, hace predicciones, mide sus errores y ajusta sus pesos, una y otra vez, durante semanas o meses en miles de GPUs. Al final queda un archivo de números, el modelo entrenado. Pasa una vez por versión del modelo, y es la parte cara.
La inferencia es todo lo que viene después: usar el modelo entrenado para responder. Cada vez que le mandás un prompt a Claude o a ChatGPT, eso es una inferencia. Los pesos no cambian; el modelo pasa la entrada por la red y produce una salida, token por token. Cada una es barata comparada con el entrenamiento, pero hay miles de millones, así que la inferencia termina siendo la mayor parte de la cuenta de cómputo.
Esta división explica mucho de lo que leés en las noticias. La 'fecha de corte' de un modelo es donde terminan sus datos de entrenamiento. El fine-tuning es una ronda corta extra de entrenamiento con ejemplos específicos. 'Servir' un modelo es correr inferencia para los usuarios; por eso las empresas necesitan data centers llenos de GPUs incluso cuando el modelo ya está terminado.
Ejemplo: un modelo que lee radiografías de tórax se entrena con cientos de miles de placas etiquetadas durante varias semanas. Después, en un hospital, mira una placa nueva en menos de un segundo. Ese segundo es inferencia.
Para quedarse
- El entrenamiento ajusta los pesos; la inferencia los usa sin cambiarlos.
- Entrenar es un costo enorme por única vez; inferir es un costo chico repetido miles de millones de veces.
- El fine-tuning es una ronda corta y puntual de entrenamiento extra.
- Las dos corren casi siempre en GPUs, pero un modelo chico puede inferir en una laptop o un celular.
Para seguir leyendo
- 3Blue1Brown: descenso de gradiente, cómo aprenden las redes neuronales (subtítulos en español)
- NVIDIA: la diferencia entre entrenamiento e inferencia (en inglés)
- Aprendizaje automático en Wikipedia