LLM
Una red neuronal entrenada con muchísimo texto para predecir la próxima palabra.
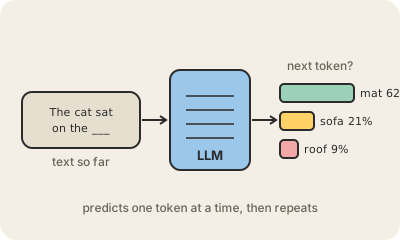
Un LLM (Large Language Model, modelo de lenguaje grande) es una red neuronal entrenada con una cantidad enorme de texto: libros, sitios web, código, conversaciones. Su único trabajo durante el entrenamiento es adivinar el próximo token de una secuencia. Hacelo lo suficientemente bien sobre billones de palabras y el modelo termina absorbiendo gramática, hechos, estilos de escritura y una cantidad sorprendente de razonamiento.
Cuando escribís una pregunta en Claude o en ChatGPT, el modelo no busca nada en ningún lado. Lee tu prompt, lo convierte en tokens y produce la respuesta de a un token por vez, eligiendo cada vez una continuación probable. El texto que ves es esa cadena de predicciones, pegada.
'Grande' se refiere a la cantidad de pesos (parámetros), miles de millones, y a la escala de datos y de horas de GPU que llevó entrenarlo. Los modelos más grandes suelen generalizar mejor, pero también son más lentos y más caros de correr; por eso las empresas ofrecen varios tamaños del mismo modelo.
Los LLMs importan porque convirtieron el lenguaje en una interfaz: describís lo que querés en palabras comunes y recibís un borrador, un resumen, una traducción o código que funciona. También inventan cosas con total seguridad (alucinación), así que funcionan mejor con una persona revisando el resultado.
Para quedarse
- Un LLM genera texto de a un token por vez, prediciendo el más probable.
- Su conocimiento queda congelado en los pesos al momento de entrenarlo; no navega salvo que le den herramientas.
- Claude, GPT, Gemini y Llama son todos LLMs; difieren en tamaño, datos y decisiones de entrenamiento.
- Que suene bien no significa que sea cierto: verificá los datos.
Para seguir leyendo
- 3Blue1Brown: ¿Qué es un GPT? (subtítulos en español)
- Modelo de lenguaje grande en Wikipedia (en inglés)