Streaming de datos
Procesar datos como un flujo continuo de eventos, segundos después de que pasan.
El streaming de datos es manejar los datos como un flujo continuo de eventos chiquitos en vez de en grandes tandas periódicas. Cada pago con tarjeta, clic, posición de GPS o lectura de un sensor se envía en el momento en que pasa, y los programas que vienen después reaccionan en segundos. Un ETL nocturno responde '¿qué pasó ayer?'; un stream responde '¿qué está pasando ahora?'.
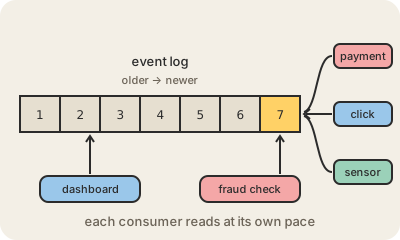
En el centro suele haber un log de eventos, como Apache Kafka o Amazon Kinesis. Los productores agregan eventos al final, el log los guarda en orden durante días, y cualquier cantidad de consumidores los lee a su propio ritmo, cada uno acordándose de dónde quedó. Como los eventos se guardan, un consumidor nuevo puede arrancar desde el principio, y uno que se cae retoma donde paró sin perder nada.
Los streams hacen andar cosas que no pueden esperar: un banco que frena un pago sospechoso antes de aprobarlo, una app de delivery que mueve al repartidor en tu mapa, una fábrica que avisa cuando una máquina se recalienta. El costo es la complejidad. Los eventos llegan tarde o desordenados, el mismo evento puede llegar dos veces, y una pregunta como 'ventas de los últimos cinco minutos' necesita ventanas sobre un flujo que nunca termina. Cuando alcanza con una respuesta por hora, un pipeline por tandas es más simple y más barato.
Para quedarse
- Los eventos se procesan de a uno, segundos después de que pasan, en vez de en tandas nocturnas.
- Un log durable como Kafka o Kinesis guarda los eventos en orden y deja que muchos consumidores los lean.
- Los eventos tardíos, duplicados o desordenados son normales y hay que manejarlos.
- Usalo cuando importan los minutos; si no, un ETL por tandas es más simple.