Almacenamiento de objetos
Archivos guardados como objetos con nombre, accesibles por la web y casi sin límite.
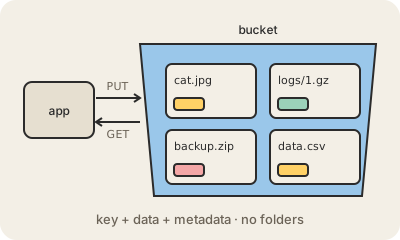
El almacenamiento de objetos (object storage) guarda los datos como objetos: un archivo entero (una foto, un video, un backup, una exportación CSV) más algunos metadatos, guardado con un nombre único llamado clave (key), dentro de un contenedor que se suele llamar bucket. No hay carpetas reales ni discos que administrar; guardás un objeto con un pedido PUT por HTTP y lo recuperás con un GET. Amazon S3 popularizó este modelo, y Google Cloud Storage, Azure Blob Storage y muchos otros lo siguen.
Es distinto de los dos tipos de almacenamiento más viejos. El almacenamiento en bloques, como el disco de una notebook o un volumen EBS, se divide en bloques chicos que la computadora formatea y modifica en el lugar, algo rápido para bases de datos. El almacenamiento de archivos es la unidad compartida con carpetas que muchas máquinas abren a la vez. El de objetos renuncia a editar en el lugar (reemplazás el objeto entero) y a cambio escala a miles de millones de objetos, reparte copias en varios centros de datos para no perder nada y es barato por gigabyte.
Esa combinación lo vuelve el lugar por defecto para cosas que se escriben una vez y se leen muchas: imágenes y videos de sitios web, archivos que suben los usuarios, backups, logs y los archivos de un data lake. La mayoría de los proveedores ofrece clases de almacenamiento, de rápidas a archivo, donde los datos fríos cuestan menos de guardar pero más, o más tiempo, de recuperar.
Para quedarse
- Los datos se guardan como objetos enteros con clave y metadatos, dentro de buckets.
- Se leen y escriben por HTTP con pedidos simples como PUT y GET.
- Los objetos se reemplazan, no se editan en el lugar, a diferencia del almacenamiento en bloques o de archivos.
- Barato, durable y casi ilimitado: el hogar de backups, contenido multimedia y data lakes.