Alta disponibilidad
Diseñar un sistema para que siga funcionando cuando falla una de sus partes.
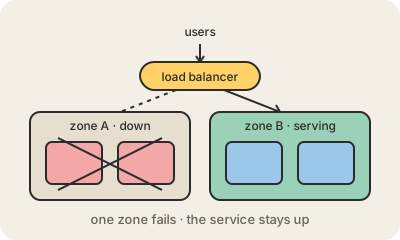
La alta disponibilidad (high availability, HA) es el objetivo de mantener un servicio funcionando casi todo el tiempo, aunque se rompan partes. Los servidores se cuelgan, los discos fallan, las redes se cortan y centros de datos enteros se quedan sin luz; un sistema de alta disponibilidad está armado para que ninguno de esos eventos, por sí solo, lo tire abajo. Se suele medir como porcentaje de tiempo en línea, por ejemplo 99,9% o 99,99%.
La idea central es la redundancia: que no haya un punto único de falla. En lugar de un servidor, varios detrás de un balanceador de carga. En lugar de un centro de datos, repartirlos en dos o tres zonas de disponibilidad, edificios separados dentro de la misma región de la nube. Tener una copia de la base de datos en espera que tome el control sola si la principal falla, un cambio que se llama failover. Los chequeos de salud prueban cada pieza todo el tiempo y desvían el tráfico de lo que deja de responder.
La alta disponibilidad se ocupa de las fallas de todos los días y mantiene el servicio andando a través de ellas, muchas veces sin que nadie se entere. La recuperación ante desastres es el plan para el evento grande y raro que voltea una región entera. Cada "nueve" extra de disponibilidad cuesta más en máquinas duplicadas y trabajo de ingeniería, así que los equipos eligen una meta acorde a cuánto duele de verdad una caída, y la dejan por escrito en un SLA.
Para quedarse
- Mantiene un servicio en pie cuando fallan servidores, discos o centros de datos.
- Se basa en la redundancia: sin puntos únicos de falla, repartido en zonas de disponibilidad.
- Los chequeos de salud y el failover automático desvían el tráfico de las partes rotas.
- Cada nueve extra cuesta más; ajustá la meta al impacto real.