Recuperación ante desastres
El plan para volver a tener sistemas y datos después de una falla grave.
La recuperación ante desastres (disaster recovery, o DR) es cómo una organización vuelve a poner en marcha sus sistemas después de que algo grande sale mal: se cae un centro de datos o una región entera de la nube, un ataque de ransomware cifra los servidores, un deploy fallido arruina la base de datos o una inundación llega al edificio. Los backups son parte, pero el DR es el plan completo: qué se restaura primero, dónde corre, quién decide y cuánto tarda todo.
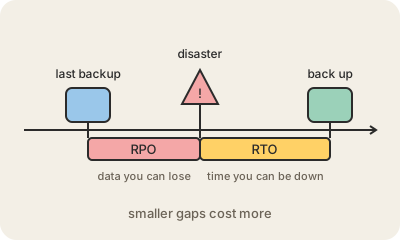
Dos números definen cada plan. El RPO (objetivo de punto de recuperación) es cuántos datos te podés permitir perder, medido en tiempo: un RPO de una hora significa perder como mucho la última hora de cambios. El RTO (objetivo de tiempo de recuperación) es cuánto tiempo te podés permitir estar caído. Un blog puede aceptar un día para los dos; un sistema de pagos puede necesitar segundos. Cuanto más exigentes, más caros, porque requieren más copias, más automatización y capacidad de repuesto lista para usar.
En la nube, las estrategias habituales van de baratas y lentas a caras y rápidas: backup y restauración en otra región, un pilot light con solo las piezas centrales prendidas, un warm standby con una copia más chica de todo, y activo-activo, donde dos regiones atienden tráfico a la vez. Elijas lo que elijas, el plan solo funciona si se practica; los equipos hacen simulacros periódicos en los que realmente pasan a la otra región y miden cuánto tardan.
Para quedarse
- Abarca restaurar sistemas y datos después de una falla grave, no solo guardar copias.
- RPO: cuántos datos podés perder. RTO: cuánto tiempo podés estar caído.
- Las estrategias van desde backup y restauración hasta activo-activo entre regiones.
- Los planes que no se prueban fallan: hacé simulacros seguido.