Amazon Athena
Corré SQL directo sobre archivos guardados en S3, sin armar ninguna base de datos.
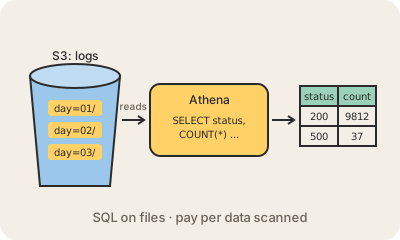
Amazon Athena es un servicio de consultas: lo apuntás a archivos guardados en Amazon S3 (CSV, JSON, Parquet, logs), describís sus columnas una vez, y corrés SQL estándar sobre ellos. No hay servidor que prender ni datos que cargar: Athena lee los archivos cuando ejecutás la consulta, y pagás por la cantidad de datos que escanea (unos 5 dólares por terabyte, aproximadamente).
Existe porque muchísimos datos valiosos viven como archivos y no adentro de una base de datos: logs de aplicaciones, exportaciones de otros sistemas, clickstreams, lecturas de sensores. Cargar todo eso en un Data warehouse es lento y caro; con Athena lo consultás donde está. Es el motor de consultas del patrón data lake: S3 como almacenamiento, el AWS Glue Data Catalog como lista de tablas y columnas, Athena como capa SQL.
Ejemplo: una empresa guarda un año de logs de su servidor web en S3, en una carpeta por día. Una analista corre SELECT status, COUNT(*) FROM logs WHERE day = '2026-10-01' GROUP BY status y tiene la respuesta en segundos, escaneando solo la carpeta de ese día. Convertir los logs a Parquet, un formato comprimido orientado a columnas, hace que la misma consulta escanee mucho menos y cueste mucho menos.
Athena está construido sobre Trino (antes Presto) y también puede correr Apache Spark. Brilla para análisis puntuales y reportes programados; para un equipo que pega todo el día a las mismas tablas y espera respuestas en menos de un segundo, un warehouse como Amazon Redshift encaja mejor.
Para quedarse
- SQL serverless sobre archivos en S3: sin cluster que correr, sin paso de carga.
- Se cobra por datos escaneados, así que formatos columnares como Parquet y particiones por carpeta bajan mucho el costo.
- Las definiciones de tablas viven en el Glue Data Catalog y se comparten con otras herramientas de AWS.
- Ideal para análisis puntuales y logs; un warehouse conviene para cargas pesadas y constantes.