Amazon Redshift
El data warehouse de AWS: SQL sobre tablas enormes, pensado para analizar, no para apps.
Redshift es el data warehouse de AWS: una base de datos diseñada para responder preguntas de análisis sobre cantidades muy grandes de datos, como "facturación por país y por mes de los últimos cinco años". Cargás datos de tus apps, de Amazon S3 o de otras fuentes, y los analistas los consultan con SQL, casi siempre desde una herramienta de dashboards.
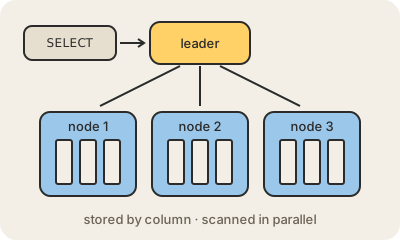
Dos decisiones de diseño lo hacen rápido para eso. Guarda los datos por columna en vez de por fila, así una consulta que solo necesita country y amount lee esas dos columnas, muy comprimidas. Y reparte cada tabla entre varias máquinas (nodos) que trabajan en paralelo: un nodo líder planifica la consulta, cada nodo de cómputo recorre su parte, y el líder junta las respuestas.
Lo podés usar como un cluster aprovisionado con una cantidad fija de nodos, o como Redshift Serverless, donde AWS suma capacidad mientras corren las consultas y pagás por el cómputo que realmente usaste. También puede consultar archivos que se quedan en S3, sin cargarlos. Para lo que no sirve es para el ida y vuelta de lecturas y escrituras chiquitas detrás del checkout de una app; eso es trabajo de una base de datos común como Amazon RDS o Amazon DynamoDB.
Para quedarse
- Un data warehouse columnar que se consulta con SQL (su dialecto viene de PostgreSQL).
- Reparte los datos entre nodos que leen en paralelo.
- Viene como clusters aprovisionados o como Redshift Serverless.
- Hecho para análisis sobre tablas grandes, no para las muchas transacciones chicas de una app.