Parquet
Un formato que guarda tablas por columna y comprimidas, para que analizar lea mucho menos.
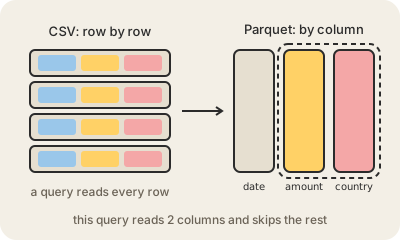
Parquet (Apache Parquet) es un formato de archivo abierto para tablas, pensado para análisis. Un CSV escribe una tabla fila por fila; Parquet la escribe columna por columna: todas las fechas juntas, después todos los montos, después todos los países. Es binario y no texto plano, así que no lo podés abrir con un editor de texto, pero casi todas las herramientas de datos lo leen: Spark, Amazon Athena, pandas, DuckDB y los principales data warehouses.
Guardar por columna rinde dos veces. Primero, una consulta que necesita dos columnas de cincuenta lee solo esas dos y se saltea el resto del archivo. Segundo, los valores de una columna se parecen (los mismos pocos países repetidos millones de veces), así que se comprimen muy bien, muchas veces a una fracción del tamaño del CSV. Cada archivo además anota el mínimo y el máximo de cada columna en cada bloque de filas, así una consulta por marzo puede saltear los bloques que solo tienen enero.
Parquet también guarda el esquema adentro del archivo: nombres y tipos de las columnas, así una fecha sigue siendo una fecha y nadie tiene que adivinar. Por eso se volvió el formato por defecto del data lake: motores como Athena cobran por datos escaneados, y pasar logs crudos de CSV o JSON a Parquet puede hacer que la misma consulta sea más rápida y mucho más barata. La contra es que está hecho para escribir una vez y leer muchas; cambiar una sola fila implica reescribir un archivo.
Para quedarse
- Columnar: una consulta lee solo las columnas que necesita.
- Los valores parecidos quedan juntos, así que comprime mucho mejor que un CSV.
- El esquema viaja adentro del archivo, con tipos de verdad.
- Hecho para análisis de escribir una vez y leer muchas, no para editar filas sueltas.
Para seguir leyendo
- Introducción a Parquet (documentación de Apache Parquet, en inglés)
- Apache Parquet en Wikipedia (en inglés)