Catálogo de datos
Un inventario con buscador de los datos de una organización y qué significa cada uno.
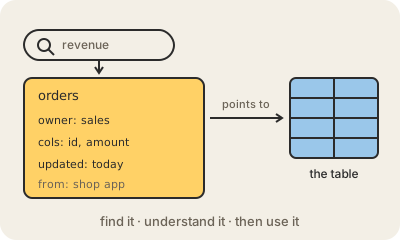
Un catálogo de datos (data catalog) es un inventario de los datos que tiene una organización: cada tabla, archivo y tablero, con una descripción de qué contiene, quién es responsable, cuándo se actualizó por última vez y cómo se conecta con el resto. No guarda los datos en sí; guarda metadatos sobre ellos y apunta a dónde viven.
El uso de todos los días es buscar. Una analista que necesita "facturación mensual por país" lo escribe en el catálogo, encuentra la tabla correcta en el data warehouse, ve que la columna amount está en dólares y no incluye devoluciones, y sabe a quién preguntarle si algo no cierra. Muchos catálogos también muestran el linaje: qué procesos generaron una tabla y qué reportes dependen de ella.
Los catálogos existen porque los datos crecen más rápido que la memoria de cualquiera. En un data lake con miles de carpetas, un archivo que nadie encuentra ni entiende es casi como si no existiera. Herramientas como AWS Glue Data Catalog, Dataplex de Google, Unity Catalog o DataHub, que es open source, cumplen este rol, y el catálogo suele ser el lugar donde las reglas del gobierno de datos se vuelven visibles para todos.
Para quedarse
- Lista conjuntos de datos con descripción, dueño, columnas y última actualización.
- Guarda metadatos y referencias, no los datos en sí.
- El linaje muestra de dónde sale una tabla y qué depende de ella.
- Evita que un data lake se convierta en un pantano.
Para seguir leyendo
- ¿Qué es un catálogo de datos? (AWS)
- ¿Qué es un catálogo de datos? (IBM)
- Data catalog en Wikipedia (en inglés)