RAG
Dejar que el modelo busque en tus documentos antes de responder.
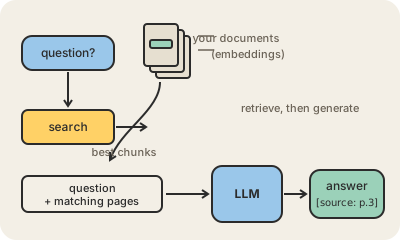
RAG (Retrieval-Augmented Generation, generación aumentada por recuperación) es una forma de hacer que un LLM responda a partir de documentos que nunca vio durante el entrenamiento: los manuales de tu empresa, los contratos de la semana pasada, un catálogo de productos. En vez de reentrenar el modelo, buscás las páginas relevantes en el momento de la pregunta y las pegás en el prompt. El modelo escribe su respuesta con esas páginas adelante.
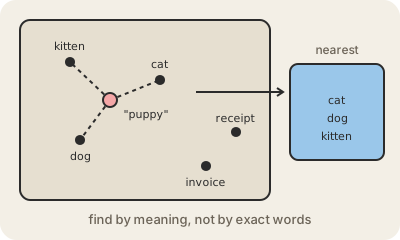
Funciona en dos pasos. Primero, la recuperación: los documentos se parten en fragmentos y cada fragmento se convierte en embeddings, números que capturan su significado, guardados en una base de datos. Cuando llega una pregunta, el sistema busca los fragmentos más cercanos en significado. Segundo, la generación: la pregunta más esos fragmentos van al LLM, que responde y puede decir de dónde sacó cada cosa.
Por qué importa: el conocimiento de un LLM queda congelado al entrenarlo, y no sabe nada privado. RAG resuelve las dos cosas sin el costo de entrenar, deja los datos donde ya viven y hace las alucinaciones menos frecuentes porque el modelo se apoya en texto real. Es la arquitectura más común detrás de los productos de 'chateá con tus documentos' y de los asistentes internos de las empresas.
Ejemplo: un bot de atención de una aerolínea. La pregunta '¿puedo llevar a mi gato?' recupera la página de la política de mascotas, y el modelo responde con esa página en vez de adivinar lo que suelen hacer las aerolíneas.
Para quedarse
- RAG agrega conocimiento en el momento de la pregunta, a través del prompt, no reentrenando.
- La recuperación suele apoyarse en embeddings y en una búsqueda vectorial.
- Las respuestas pueden citar sus fuentes, lo que las hace más fáciles de verificar.
- La calidad depende de la búsqueda: si vuelven los fragmentos equivocados, la respuesta también está mal.