Embeddings
Convertir palabras, imágenes o documentos en listas de números que capturan significado.
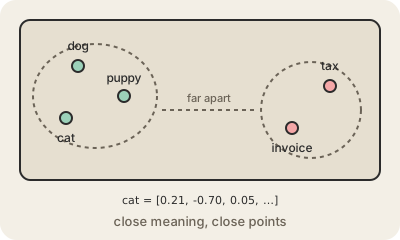
Un embedding es una lista de números (un vector) que representa un contenido: una palabra, una oración, un documento entero, una imagen. Lo produce una red neuronal de manera que las cosas con significado parecido reciban números parecidos. 'Perro' y 'cachorro' quedan cerca; 'perro' y 'factura' quedan lejos. Un embedding típico tiene de unos cientos a unos miles de números.
Las computadoras no pueden comparar significados, pero comparan números muy rápido. Una vez que todo es un embedding, 'encontrá documentos parecidos a este' se convierte en 'encontrá los puntos más cercanos', un problema de geometría. Eso alimenta la búsqueda semántica (resultados que coinciden con la idea, no con las palabras exactas), las recomendaciones, la detección de duplicados y el agrupamiento.
Adentro de un LLM, cada token se convierte primero en un embedding; así entra el texto a la matemática. Afuera, los embeddings son la columna vertebral de RAG: los documentos se convierten una vez y se guardan en una base de datos vectorial, la pregunta se convierte en el momento de la consulta y se recuperan los fragmentos más cercanos.
Ejemplo: una mesa de ayuda que recibe 'se me puso negra la pantalla' tiene que encontrar el artículo 'El monitor no enciende' aunque no coincida ninguna palabra. Con embeddings, las dos oraciones quedan cerca, así que la búsqueda funciona.
Para quedarse
- Un embedding es un vector; la distancia entre vectores aproxima la distancia de significado.
- El mismo modelo tiene que convertir los documentos y la consulta, o los números no son comparables.
- Las bases de datos vectoriales existen para encontrar vecinos cercanos entre millones de embeddings.
- Hay embeddings de texto, imágenes, audio y código, a veces en un mismo espacio compartido.
Para seguir leyendo
- 3Blue1Brown: ¿Qué es un GPT? (embeddings explicados en forma visual, subtítulos en español)
- Word embedding en Wikipedia (en inglés)
- OpenAI: guía de embeddings (en inglés)