Edge computing
Procesar los datos cerca de donde se generan, en lugar de en un centro de datos lejano.
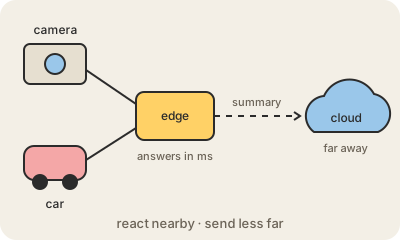
El edge computing (computación en el borde) consiste en hacer los cálculos cerca de las personas o dispositivos que los necesitan, en el "borde" de la red, en lugar de mandar todo a un gran centro de datos a cientos o miles de kilómetros. El borde puede ser un servidor chico en una fábrica o un local, un equipo en una antena de telefonía, un punto de presencia en la ciudad o el propio dispositivo: una cámara, un auto o un celular.
Las razones principales son la física y el volumen. Cada viaje a un centro de datos lejano suma latencia, y hay decisiones que no pueden esperar: un robot de fábrica que tiene que frenar si una persona se cruza, o un auto que reacciona al camino. Otras veces el problema es la cantidad de datos: un conjunto de cámaras de seguridad genera demasiado video para subirlo, así que se analiza en el lugar y solo las alertas van a la nube. Mantener los datos cerca también puede ayudar con las reglas de privacidad y seguir funcionando cuando se corta internet.
El borde y la nube trabajan juntos; uno no reemplaza al otro. Una división común es: reaccionar en el lugar y después mandar resúmenes a la nube para guardarlos, analizarlos y entrenar modelos. Los proveedores de nube ofrecen opciones de edge, desde funciones que corren en las ubicaciones de una CDN cerca de los usuarios hasta hardware que instalan en tu propio edificio. El costo es tener muchas máquinas chicas y dispersas, más difíciles de actualizar, proteger y monitorear que unas pocas grandes.
Para quedarse
- Calcula cerca del origen de los datos: en un local, una fábrica, una antena o el dispositivo.
- Reduce la latencia y la cantidad de datos que viajan por la red.
- Trabaja con la nube: reaccionar en el lugar, mandar resúmenes al centro.
- Muchas máquinas dispersas son más difíciles de actualizar, proteger y monitorear.