Big data
Datos tan grandes, rápidos o desordenados que una computadora común no puede con ellos.
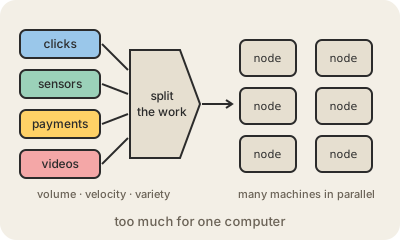
Big data (macrodatos) describe colecciones de datos demasiado grandes o rápidas para las herramientas habituales en una sola computadora. La definición clásica usa tres V: volumen (cantidades enormes, mucho más de lo que entra en una máquina), velocidad (datos que llegan todo el tiempo, como cada clic en un sitio o cada lectura de miles de sensores) y variedad (muchas formas a la vez: tablas, texto, imágenes, logs).
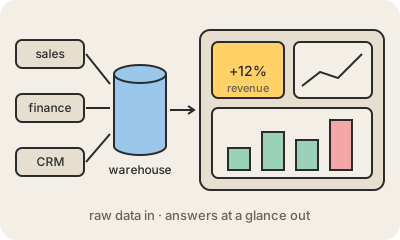
El término se hizo popular a fines de los 2000, cuando empresas como Google y Yahoo necesitaban procesar toda la web. Su respuesta fue partir los datos en pedazos y procesarlos en paralelo en muchas máquinas baratas, una idea que llevó a herramientas open source como Hadoop y, más tarde, Spark. Hoy esa misma idea mueve los data warehouses en la nube, los data lakes y los sistemas de streaming, así que una empresa puede consultar años de registros sin tener ni un servidor propio.
Hay ejemplos por todos lados: una plataforma de streaming que te recomienda series según lo que vieron millones de personas, un banco que marca un pago con tarjeta raro en tiempo real, una ciudad que ajusta los semáforos con sensores en las calles. El término en sí perdió un poco de brillo, porque manejar muchos datos se volvió normal. Lo que no cambió es la lección de fondo: más datos solo ayudan si son buenos datos y alguien les hace una pregunta útil.
Para quedarse
- Las tres V: volumen, velocidad y variedad.
- Se maneja repartiendo el trabajo entre muchas máquinas en paralelo.
- Hadoop y Spark lo empezaron; los warehouses y lakes en la nube lo volvieron común.
- Grande no es lo mismo que útil: la calidad y las buenas preguntas siguen importando.