Limpieza de datos
Corregir errores, huecos y duplicados en los datos antes de confiar en ellos.
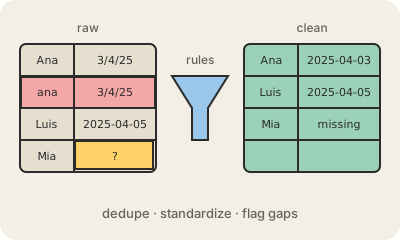
La limpieza de datos (data cleaning) es el trabajo de encontrar y corregir problemas en un conjunto de datos para poder usarlo con tranquilidad. Los datos reales son desprolijos: el mismo cliente cargado dos veces con el nombre apenas distinto, fechas escritas 03/04/2025 en un sistema y 2025-04-03 en otro, una edad de 250 años, un mail vacío, precios con coma en un país y con punto en otro.
Los pasos típicos son sacar duplicados, unificar formatos (fechas, monedas, nombres de países), decidir qué hacer con los valores que faltan (completarlos, marcarlos o descartar la fila), detectar valores imposibles y revisar que las referencias coincidan, por ejemplo que cada pedido pertenezca a un cliente que existe. Cada decisión es un criterio, así que los buenos equipos escriben las reglas y las corren como código en lugar de arreglar celdas a mano.
Es famosa por ser la parte menos vistosa y que más tiempo lleva del trabajo con datos, y también una de las más importantes. Un tablero o un modelo de machine learning es tan bueno como los datos que recibe; "basura entra, basura sale" es el dicho más viejo del rubro. En un pipeline, la limpieza suele ir en el paso de transformación del ETL, y los controles se vuelven a correr cada vez que llegan datos nuevos.
Para quedarse
- Corrige duplicados, formatos inconsistentes, valores faltantes y números imposibles.
- Cada regla es una decisión: escribila y automatizala.
- Suele ser parte del paso de transformación de un pipeline de datos.
- Basura entra, basura sale: los reportes y modelos de IA heredan cada error.