Linaje de datos
El mapa de dónde salió cada dato y de todo lo que depende de él.
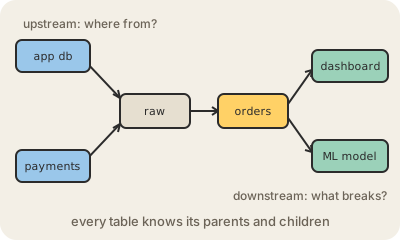
El linaje de datos (data lineage) es el registro de cómo se mueven y se transforman los datos: de qué fuentes se armó una tabla, qué procesos la modificaron y qué tablas, tableros y modelos la leen después. Casi siempre se dibuja como un grafo, con flechas que van de las fuentes crudas, a la izquierda, a los reportes, a la derecha.
Sirve para contestar dos preguntas que aparecen todas las semanas en un equipo de datos. Mirando hacia atrás: "este número de facturación está raro, ¿de dónde sale?". Mirando hacia adelante: "si le cambio el nombre a esta columna, ¿qué se rompe?". Sin linaje, las dos respuestas implican leer SQL y código de pipelines a mano. Con linaje, hacés clic en una tabla y ves sus ancestros y sus descendientes.
Puede ser a nivel de tabla (esta tabla alimenta a esa) o a nivel de columna (esta columna amount se calcula a partir de esas otras dos), que es mucho más preciso y mucho más difícil de capturar. Las herramientas actuales lo arman solas, analizando el SQL o haciendo que cada proceso informe qué leyó y qué escribió, muchas veces con el estándar abierto OpenLineage. dbt dibuja el linaje de sus modelos y los catálogos de datos lo muestran al lado de cada tabla. También importa para cumplir normas: si un cliente pide que borren sus datos, el linaje muestra todos los lugares adonde fueron a parar.
Para quedarse
- Hacia atrás explica de dónde sale un número; hacia adelante muestra qué rompe un cambio.
- El linaje por columna sirve más que el linaje por tabla, y cuesta más conseguirlo.
- Suele armarse solo, leyendo el SQL o con procesos que informan qué leen y qué escriben.
- OpenLineage es un estándar abierto para compartir linaje entre herramientas.