Función de pérdida
El número que dice cuánto se equivoca un modelo, para que entrenar sea bajarlo.
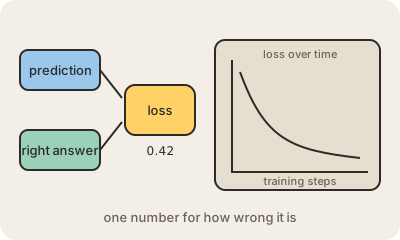
Una función de pérdida convierte los errores de un modelo en un solo número. Le mostrás un ejemplo, comparás su respuesta con la correcta y la pérdida te dice qué tan lejos quedó: cero si acertó de lleno, más grande cuanto peor le fue. Entrenar es, literalmente, buscar los pesos que hagan chico ese número en millones de ejemplos.
La fórmula depende de la tarea. Para predecir una cantidad, como el precio de una casa, una opción común es el error cuadrático medio: el promedio de las diferencias al cuadrado, que castiga mucho más los errores grandes que los chicos. Para elegir entre categorías, lo habitual es la entropía cruzada: el modelo le asigna una probabilidad a cada opción y la pérdida es alta cuando le dio poca a la correcta. Un LLM se preentrena con entropía cruzada sobre una sola pregunta, repetida a lo largo de billones de tokens: ¿cuánta probabilidad le diste al token que de verdad venía después?
La pérdida es también lo que necesita el descenso de gradiente. La retropropagación calcula cómo cambia la pérdida si cada peso se mueve un poquito, y el descenso de gradiente empuja cada peso hacia donde la pérdida baja. Eso solo funciona si la pérdida cambia de forma suave, y por eso los modelos no se entrenan directamente con la precisión (un conteo de aciertos y errores que salta de a escalones) sino con un reemplazo suave.
Mirar la pérdida es la forma de seguir un entrenamiento. Si la pérdida de entrenamiento sigue bajando mientras la pérdida con datos de validación, que el modelo no vio, empieza a subir, es la señal clásica de sobreajuste. Y una pérdida baja no es lo mismo que un modelo útil: solo mide lo que mide la fórmula. Si la fórmula premia lo que no es, el modelo se vuelve muy bueno en lo que no es.
Para quedarse
- La pérdida resume los errores de un modelo en un número; entrenar es intentar bajarlo.
- El error cuadrático medio es común para números; la entropía cruzada, para categorías y tokens.
- Tiene que cambiar de forma suave para que la retropropagación y el descenso de gradiente sigan su pendiente.
- Pérdida de entrenamiento que baja y de validación que sube: señal de sobreajuste.
Para seguir leyendo
- Función de pérdida en Wikipedia
- Regresión lineal: Pérdida (Curso intensivo de aprendizaje automático de Google)
- ¿Qué es la función de pérdida? (IBM)