Overfitting
Cuando un modelo se memoriza los ejemplos de entrenamiento en vez de aprender el patrón.
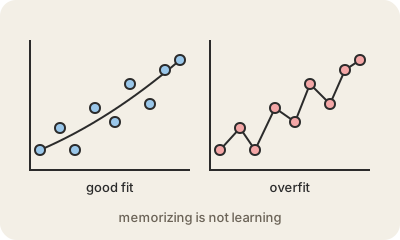
El overfitting (sobreajuste) pasa cuando un modelo de machine learning se ajusta demasiado a sus datos de entrenamiento. Aprende el patrón real, pero también el ruido, las mañas y las casualidades de esos ejemplos puntuales. Parece brillante con los datos con los que entrenó y decepciona con cualquier cosa nueva.
Imaginá un modelo que predice precios de casas. Con unos cientos de ventas para aprender, un modelo sensato entiende que importan los metros cuadrados y el barrio. Uno sobreajustado aprende que una casa se vendió cara porque tenía la puerta azul y se publicó un martes. Le acierta perfecto a cada venta pasada y le erra feo a la próxima. El problema contrario, un modelo tan simple que ni siquiera capta el patrón real, se llama underfitting.
La forma estándar de detectarlo es esconder una parte de los datos durante el entrenamiento y probar el modelo con esa parte al final. Si el resultado en la parte escondida es mucho peor que en la de entrenamiento, hay overfitting. Los remedios habituales son más datos y más variados, un modelo más simple, cortar el entrenamiento antes y técnicas agrupadas bajo el nombre de regularización, que penalizan al modelo cuando se vuelve demasiado complicado.
Para quedarse
- El modelo aprende el ruido de los ejemplos, no solo el patrón.
- Se nota en resultados buenísimos en entrenamiento y flojos con datos nuevos.
- Se detecta probando con datos que el modelo nunca vio al entrenar.
- Se combate con más datos, modelos más simples, cortar antes o regularización.