LoRA
Una forma barata de hacer fine-tuning de un modelo grande entrenando un agregado chico.
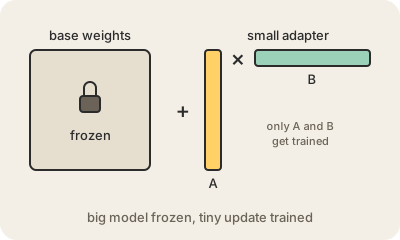
Hacer fine-tuning de un modelo grande de la forma tradicional actualiza todos sus pesos. Con miles de millones de parámetros, eso pide muchísima memoria de GPU y te deja con una copia entera del modelo por cada tarea. LoRA (Low-Rank Adaptation, adaptación de bajo rango) evita las dos cosas: congela los pesos originales y entrena solo un conjunto chico de pesos extra, un adaptador, que se suma arriba.
El truco está en la forma. Los pesos de una capa forman una matriz grande, y el fine-tuning la cambia con una matriz de actualización del mismo tamaño. LoRA apuesta a que esa actualización no necesita tanta libertad y la escribe como el producto de dos matrices finitas. Para una capa de 4096 x 4096, en vez de unos 16,8 millones de números entrenás dos tiras de, por ejemplo, 4096 x 8 cada una: unos 65.000. Ese ancho chico, 8 en el ejemplo, es el rango, la configuración principal que elegís. Al terminar, la actualización se puede fusionar con los pesos originales, así que el modelo corre igual de rápido que antes.
Investigadores de Microsoft presentaron LoRA en 2021. Con GPT-3 informaron que reducía unas 10.000 veces los parámetros a entrenar y unas 3 veces la memoria de GPU necesaria, con una calidad cercana al fine-tuning completo. QLoRA (2023) fue más allá: mantiene el modelo congelado cuantizado a 4 bits, y con eso alcanzó para hacer fine-tuning de un modelo de 65.000 millones de parámetros en una sola GPU de 48 GB.
LoRA está en todos lados alrededor de los modelos de pesos abiertos. Los adaptadores son archivos chicos, de megas y no de gigas, así que podés tener un solo modelo base e ir cambiando de adaptador según la tarea o el cliente. En generación de imágenes, la gente comparte LoRAs que le enseñan a un modelo de difusión un estilo, un personaje o un producto. La contra: una actualización de bajo rango puede aprender menos que el fine-tuning completo, y se nota en cambios grandes, como entrenar a fondo en un área totalmente nueva.
Para quedarse
- Congela el modelo base y entrena un adaptador chico de bajo rango.
- Pide muchísima menos memoria que el fine-tuning completo; los adaptadores pesan poco.
- El adaptador se puede fusionar con los pesos, así la inferencia no es más lenta.
- QLoRA suma cuantización a 4 bits para que modelos grandes entren en una GPU.
Para seguir leyendo
- ¿Qué es LoRA (adaptación de bajo rango)? (IBM)
- LoRA: Low-Rank Adaptation of Large Language Models (paper original, arXiv, en inglés)
- Guía conceptual de LoRA (Hugging Face PEFT, en inglés)