OLAP y OLTP
Dos trabajos de una base de datos: muchas transacciones chicas o pocas preguntas enormes.
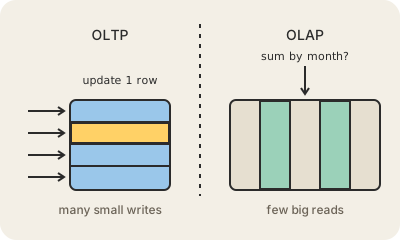
OLTP (procesamiento de transacciones en línea) es el trabajo que hay detrás de una app mientras la gente la usa: creá este pedido, cobrá esta tarjeta, actualizá esta dirección. Cada operación toca unas pocas filas, hay miles por segundo, y cada una tiene que salir bien aunque dos pasen al mismo tiempo. Bases como PostgreSQL, MySQL, Amazon RDS o DynamoDB están hechas para esto, y suelen guardar los datos fila por fila, con índices para encontrar un registro rápido.
OLAP (procesamiento analítico en línea) es el trabajo de hacerle preguntas grandes a toda esa historia: facturación por región y por mes de los últimos cinco años, o qué productos se compran juntos. Una sola consulta lee millones o miles de millones de filas pero pocas columnas, y a nadie le molesta esperar unos segundos. Los data warehouses como Snowflake, BigQuery o Amazon Redshift están hechos para esto: guardan los datos columna por columna (como los archivos Parquet), así cada consulta lee solo lo que necesita y todo se comprime bien.
Los dos se mantienen separados a propósito. Correr un reporte pesado en la base OLTP de producción puede trabar el checkout de clientes reales, y un warehouse en columnas es torpe para actualizar una fila por vez. Por eso los datos se copian de los sistemas OLTP a uno OLAP con ETL o streaming. Algunos sistemas más nuevos, llamados HTAP, intentan hacer las dos cosas, pero la separación sigue siendo el diseño habitual en la mayoría de las empresas.
Para quedarse
- OLTP: muchas lecturas y escrituras chicas, guardado por filas, exactitud bajo carga.
- OLAP: pocas consultas grandes sobre la historia, guardado en columnas, agregaciones.
- Los datos pasan de los sistemas OLTP a un warehouse OLAP con ETL o streaming.
- Separarlos protege a la app en vivo de los reportes pesados.