IA multimodal
IA que entiende, o produce, más de un tipo de dato: texto, imágenes, sonido, video.
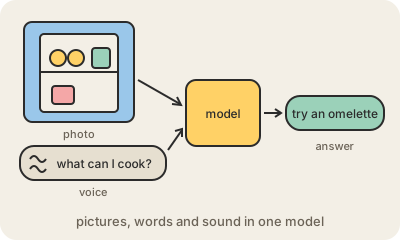
La IA multimodal es la IA que trabaja con más de un tipo de información, o 'modo', al mismo tiempo: texto, imágenes, audio, video. Un modelo multimodal puede mirar una foto y responder una pregunta sobre ella, escuchar tu voz y contestarte en voz alta, leer un gráfico dentro de un PDF o tomar un boceto y convertirlo en una página web que funciona.
Los sistemas de antes manejaban cada modo por separado y los encadenaban: un programa pasaba la voz a texto, un modelo de lenguaje respondía y otro programa leía la respuesta en voz alta. En cada paso se perdían detalles, como el tono de voz o lo que había en la imagen. Los modelos multimodales modernos se entrenan con texto, imágenes y sonido juntos, así que conectan la palabra 'perro' con fotos de perros y con el sonido de un ladrido dentro de un mismo modelo. La mayoría de los asistentes actuales, incluidos ChatGPT, Claude y Gemini, aceptan imágenes además de texto, y varios también manejan audio y video.
Eso abre usos prácticos. Sacale una foto a un mensaje de error raro, al prospecto de un remedio o a una pieza rota y preguntá qué significa. Personas ciegas o con baja visión usan apps que les describen el entorno a través de la cámara del celular. Las empresas procesan formularios escaneados, facturas y capturas de pantalla sin volver a tipearlos. La advertencia de siempre vale todavía más: el modelo puede leer mal una imagen, pasar por alto un detalle chico o describir algo que no está, así que las lecturas importantes necesitan que las mire una persona.
Para quedarse
- Maneja varios tipos de entrada o salida en un mismo modelo.
- Lo más común hoy: imagen más texto; muchos también hacen voz y video.
- Se entrena con datos mezclados, así que une palabras con imágenes y sonidos.
- Puede leer mal una imagen, así que revisá lo que importa.