Ventana de contexto
Cuánto texto puede tener en cuenta un modelo de IA a la vez, medido en tokens.
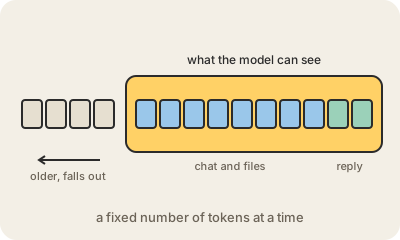
La ventana de contexto (context window) es la cantidad de texto que un modelo de lenguaje puede mirar de una sola vez. Todo lo que el modelo usa para responder tiene que entrar ahí: las instrucciones ocultas de la app, tu conversación hasta el momento, los documentos que pegaste o subiste y la respuesta que está escribiendo. Se mide en tokens, los pedacitos de texto con los que trabajan los modelos; en inglés un token es más o menos tres cuartos de palabra, y en español suele rendir un poco menos.
Un modelo no tiene memoria propia entre mensaje y mensaje. Cuando chateás, la app le vuelve a mandar toda la conversación en cada turno, y así es como 'se acuerda' de lo que dijiste. Cuando la conversación o los documentos superan la ventana, algo tiene que salir: los mensajes viejos se descartan o se resumen, y el modelo directamente deja de verlos. Por eso un chat muy largo puede empezar a olvidarse de detalles del principio.
Las ventanas de contexto crecieron mucho, de unos pocos miles de tokens en los primeros chatbots a cientos de miles, y en algunos modelos más de un millón, que alcanza para varios libros. Más grande no es gratis: los textos largos cuestan más, tardan más y los modelos pueden prestarles menos atención a los detalles enterrados en el medio de un texto enorme. Para colecciones grandes de documentos suele ser mejor recuperar solo las partes relevantes (RAG) que pegar todo.
Para quedarse
- Es todo lo que el modelo ve a la vez: instrucciones, chat, archivos y respuesta.
- Se mide en tokens; en inglés, un token es más o menos tres cuartos de palabra.
- Pasado el límite, lo más viejo se descarta o se resume.
- Ventanas más grandes cuestan más, y el medio de un texto muy largo recibe menos atención.