Guardrails de IA
Controles alrededor de un modelo de IA para frenar preguntas y respuestas no deseadas.
Los guardrails de IA (literalmente, barandas de contención) son las reglas y filtros que una empresa pone alrededor de un modelo de lenguaje para que su app se comporte como corresponde. El modelo ya viene entrenado para ser útil y no hacer daño, pero el asistente de un banco necesita límites más específicos: no dar consejos de inversión, no hablar de la competencia, nunca mostrar un número de tarjeta completo, mantener la buena educación aunque el cliente no la tenga.
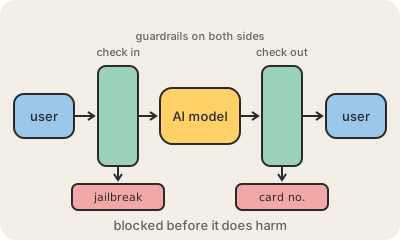
En general se ubican a los dos lados del modelo. Un control de entrada mira lo que manda el usuario y bloquea o reescribe cosas como intentos de jailbreak, inyección de prompts o pedidos que no tienen nada que ver. Un control de salida lee la respuesta del modelo antes de que la vea el usuario: puede ocultar datos personales, frenar lenguaje tóxico, rechazar temas prohibidos o verificar que la respuesta esté respaldada por los documentos de la empresa, para bajar las alucinaciones. Algunos guardrails son reglas simples, como una lista de palabras prohibidas; otros son un segundo modelo, más chico, que juzga al primero.
Los proveedores cloud lo venden como servicio, por ejemplo Amazon Bedrock Guardrails, y también hay herramientas open source. No son perfectos: muy estrictos bloquean preguntas razonables, muy laxos dejan pasar cosas. Funcionan mejor como una capa más entre varias, junto con prompts cuidados, permisos limitados y revisión humana donde lo que está en juego es importante.
Para quedarse
- Los controles de entrada filtran lo que llega al modelo; los de salida, lo que llega al usuario.
- Tareas típicas: bloquear temas, ocultar datos personales, frenar jailbreaks, reducir respuestas inventadas.
- Pueden ser reglas simples o un segundo modelo que hace de juez.
- Muy estrictos molestan, muy laxos dejan pasar problemas: hay que ajustarlos.
Para seguir leyendo
- Amazon Bedrock Guardrails (documentación oficial)
- Mitigate jailbreaks and prompt injections (documentación de Claude, en inglés)
- AI Risk Management Framework (NIST, en inglés)