Unicode
La numeración universal de cada letra y símbolo, y por qué a veces se rompen los acentos.
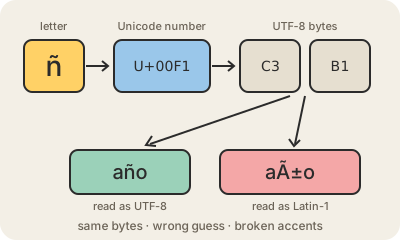
Las computadoras guardan el texto como números, así que cada carácter necesita uno. Unicode es el estándar mundial que se los asigna: la A es U+0041, la ñ es U+00F1, la Ω griega es U+03A9 y el emoji 😀 es U+1F600. Cubre prácticamente todos los sistemas de escritura en uso, además de muchos históricos y montones de símbolos: bastante más de cien mil caracteres en total. Antes de Unicode, cada región usaba su propia tabla incompatible, y un archivo escrito en una muchas veces salía desfigurado en otra.
Unicode dice qué número le toca a cada carácter; una codificación dice cómo escribir esos números como bytes en un archivo o en un mensaje por la red. La que domina es UTF-8. Guarda las letras básicas del inglés en un byte cada una, exactamente igual que el viejo estándar ASCII, y usa de dos a cuatro bytes para todo lo demás. Esa compatibilidad hacia atrás es una gran razón de su éxito: hoy la enorme mayoría de las páginas web están en UTF-8.
Cuando se rompen los acentos, casi siempre es por esto. Si un programa escribe "año" en UTF-8 y otro lee esos bytes suponiendo una codificación más vieja, como Latin-1, cada mitad de la ñ de dos bytes se muestra como un carácter aparte y aparece "año". Ese engendro tiene nombre: mojibake. El arreglo casi nunca es corregir el texto a mano, sino lograr que las dos partes estén de acuerdo en que el texto es UTF-8.
Para quedarse
- Unicode le da a cada carácter, de la A a la ñ y los emoji, un número único.
- UTF-8 es la forma más común de guardar esos números como bytes.
- Un texto en inglés básico en UTF-8 es idéntico al viejo ASCII.
- Ver "ñ" en vez de "ñ" significa que el texto se leyó con la codificación equivocada.