Temperatura
El ajuste que hace que las respuestas de un modelo de IA sean más previsibles o variadas.
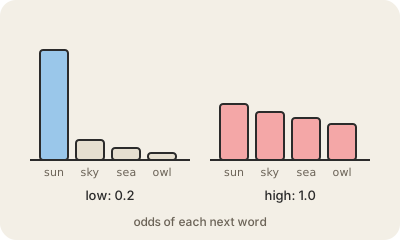
Un LLM escribe de a un token por vez, y en cada paso tiene una lista de posibles tokens siguientes, cada uno con una probabilidad. La temperatura es un número que mandás junto con tu pedido y que cambia cómo elige el modelo dentro de esa lista. El nombre viene de la física, donde el calor hace que las partículas se muevan de forma más desordenada.
Con una temperatura baja, cerca de 0, el modelo casi siempre se queda con la opción más probable. Las respuestas salen enfocadas, repetitivas y muy parecidas de una vez a la otra. Con una temperatura más alta, las opciones menos probables tienen chances reales, así que el texto sale más variado y sorprendente, y pasado cierto punto también más divagante y con más errores. El rango depende del proveedor: la API de Anthropic acepta de 0 a 1, la de OpenAI de 0 a 2.
En la práctica: dejala baja para tareas con una sola respuesta correcta, como sacar datos de una factura, clasificar un mensaje o escribir código; subila para tirar ideas, buscar nombres o escribir ficción, cuando querés opciones. Ni siquiera en 0 está garantizado que la salida sea idéntica cada vez, y algunos modelos de razonamiento nuevos fijan la temperatura y no te dejan tocarla. Muchas veces se combina con top-p, que corta la cola larga de tokens poco probables.
Para quedarse
- Controla cuánto azar entra en la elección de cada token siguiente.
- Baja es enfocada y constante; alta es variada y creativa.
- Baja para extraer datos, clasificar y programar; más alta para ideas.
- Los rangos cambian según el proveedor, y 0 no garantiza la misma salida.
Para seguir leyendo
- Referencia de la Messages API, parámetro temperature (Anthropic, en inglés)
- Función softmax en Wikipedia