Mezcla de expertos
Un modelo armado con muchas subredes, donde solo unas pocas trabajan en cada token.
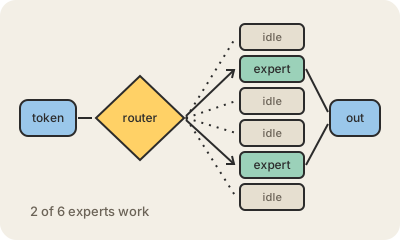
Una mezcla de expertos (MoE, por mixture of experts) es una forma de armar una red neuronal para que pueda ser enorme sin volverse lenta. Dentro de algunas capas de un transformer, en lugar de un único bloque grande que procesa todos los tokens, hay muchos bloques más chicos llamados expertos, más un router chiquito que decide, para cada token, qué dos o tres expertos se encargan. El resto queda quieto para ese token.
Eso parte el tamaño del modelo en dos números. La cantidad total de parámetros es lo que el modelo sabe; la cantidad de parámetros activos es lo que gasta en cada token. Mixtral 8x7B, que Mistral AI publicó a fines de 2023 como modelo de pesos abiertos, tiene unos 47 mil millones de parámetros en total pero usa más o menos 13 mil millones por token. DeepSeek-V3 tiene alrededor de 671 mil millones en total y unos 37 mil millones activos. Se cree que muchos de los modelos más grandes de hoy usan alguna variante de MoE, aunque la mayoría de los laboratorios no publica su arquitectura.
La ventaja es entrenar más barato e inferir más rápido para una misma cantidad de conocimiento. Los costos son menos evidentes: todos los expertos tienen que estar cargados en memoria igual, así que necesitás mucha RAM de GPU aunque la mayor parte esté ociosa en cada momento; el router hay que entrenarlo para que reparta la carga parejo en vez de elegir siempre a los mismos favoritos; y los expertos no se vuelven especialistas prolijos en medicina o derecho, como sugiere el nombre. Se especializan en patrones de tokens que casi nunca coinciden con temas humanos.
Para quedarse
- Un router manda cada token a unos pocos expertos entre muchos.
- Los parámetros totales pueden ser enormes y los activos por token, pocos.
- Más barato de entrenar y correr, pero todos los expertos tienen que entrar en memoria.
- Los expertos aprenden patrones de tokens, no materias humanas prolijas.
Para seguir leyendo
- Mezcla de expertos en Wikipedia
- Mixture of Experts Explained (Hugging Face, en inglés)
- Paper de Mixtral of Experts (arXiv, en inglés)