Amazon Textract
Un servicio de AWS que lee documentos escaneados y saca texto, formularios y tablas.
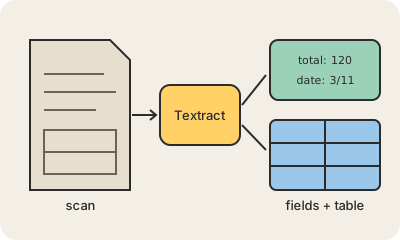
Amazon Textract agarra una imagen o un PDF de un documento, como un formulario escaneado, un ticket o un resumen bancario, y te devuelve su contenido como datos que un programa puede usar. En lo más básico hace OCR, reconocimiento óptico de caracteres: encuentra las palabras escritas a máquina y a mano, y dónde están en la página.
Lo que lo diferencia de un OCR común es que entiende la estructura. Puede leer un formulario y emparejar cada etiqueta con su valor ("Nombre: Ana Pérez"), reconstruir una tabla fila por fila y celda por celda, y responder consultas (queries) como "¿cuál es el número de póliza?" aunque ese dato esté en un lugar distinto en cada documento. Tiene operaciones especiales para facturas y tickets, y para documentos de identidad como licencias de conducir y pasaportes de Estados Unidos.
Se usa sobre todo para automatizar papeleo: cargar facturas en el sistema contable, procesar reclamos de seguros o pedidos de préstamo, o hacer buscables archivos llenos de escaneos. Cada resultado trae un puntaje de confianza, así que un patrón común es dejar pasar solos los campos con confianza alta y mandar los dudosos a una persona para que los revise.
Para quedarse
- Extrae texto escrito a máquina y a mano de imágenes y PDF.
- Entiende formularios (etiqueta y valor) y tablas, no solo palabras sueltas.
- Con queries le pedís un dato puntual en forma de pregunta.
- Los puntajes de confianza ayudan a decidir qué tiene que revisar una persona.
Para seguir leyendo
- ¿Qué es Amazon Textract? (documentación oficial)
- Página de Amazon Textract
- Reconocimiento óptico de caracteres en Wikipedia