Minería de datos
Excavar en grandes cantidades de datos para encontrar patrones que nadie anotó.
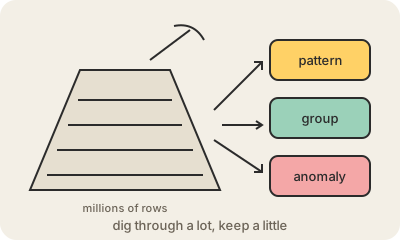
La minería de datos (data mining) es buscar en conjuntos de datos grandes patrones útiles pero no evidentes: qué productos se compran juntos, qué clientes se comportan parecido, qué transacciones se ven raras. No se arranca con una pregunta precisa, del tipo "¿cuánto vendimos en mayo?"; la idea es que los datos te muestren algo que no sabías que tenías que preguntar.
Hay algunos tipos de resultado que aparecen siempre. Las reglas de asociación encuentran cosas que pasan juntas, como un supermercado que nota que quien compra fideos suele llevar queso rallado en la misma compra. El clustering agrupa clientes o pacientes parecidos sin que nadie le diga de antemano cuáles son los grupos. La clasificación aprende a ordenar casos nuevos, por ejemplo un banco que marca pagos con tarjeta que se parecen a fraudes anteriores. La detección de anomalías encuentra registros que no encajan en ningún patrón.
El término se hizo popular en los años noventa, y hoy la mayoría de estas técnicas viven bajo el paraguas del machine learning y la ciencia de datos. Las precauciones son las de siempre. Si buscás suficientes patrones en suficientes datos, algunos van a aparecer por pura casualidad, así que los hallazgos hay que comprobarlos con datos nuevos. Y minar datos personales abre preguntas de privacidad que leyes como el RGPD intentan responder.
Para quedarse
- Encuentra patrones en datos grandes sin una pregunta precisa de antemano.
- Resultados típicos: cosas que van juntas, grupos, predicciones, anomalías.
- Hoy se superpone mucho con el machine learning y la ciencia de datos.
- Los patrones que salen por casualidad hay que comprobarlos con datos nuevos.